Qué es el crawl budget
El crawl budget o presupuesto de rastreo describe los recursos que un buscador dedica a descargar páginas de un sitio. Depende de su capacidad de rastreo y de la demanda de actualización. Rastrear una URL no equivale a indexarla ni a posicionarla.
En una web pequeña, suele ser más importante comprobar acceso, contenido y enlaces que optimizar una supuesta cuota de Googlebot. El presupuesto de rastreo cobra más relevancia en sitios grandes, catálogos cambiantes o estructuras que generan muchas URLs innecesarias, como explica la guía oficial de gestión del crawl budget.
Capacidad y demanda de rastreo
La capacidad considera cuánto puede descargar Google sin sobrecargar el sitio. Un servidor inestable o lento puede limitar el acceso. La demanda depende de factores como el inventario de URLs, su actualización y su importancia; no aumenta automáticamente por publicar todos los días.
Un sitio puede responder correctamente y tener URLs sin indexar. En ese caso, revisa el motivo y la utilidad de la página antes de atribuirlo a falta de presupuesto.
Cuándo merece la pena analizarlo
| Situación | Prioridad de revisión |
|---|---|
| Web corporativa con decenas de páginas | Acceso, indexación de servicios y enlaces internos |
| Tienda con filtros que generan miles de combinaciones | Inventario de URLs y navegación facetada |
| Catálogo que cambia con frecuencia | Descubrimiento y actualización de páginas relevantes |
| Servidor con fallos o latencia sostenida | Estabilidad y capacidad de respuesta |
| Muchas URLs descubiertas sin rastrear | Alcance, enlazado, duplicados y registros del servidor |
No uses la falta de clics como medida de falta de rastreo. Son fases distintas. Para diagnosticar una URL concreta, consulta por qué tu web no aparece en Google.
Cómo mejorar la eficiencia de rastreo
1. Definir qué páginas necesitas
Prepara un inventario de servicios, productos, categorías, artículos y variantes técnicas. Decide qué URLs tienen contenido propio y qué combinaciones son meros filtros. La arquitectura debe ayudar a usuarios y buscadores a encontrar las páginas importantes.
Ejemplo orientativo: una tienda de calzado puede necesitar una categoría de botas de montaña, mientras cada combinación de orden por precio, talla y color no necesita una landing indexable. La decisión depende de demanda, catálogo y contenido disponible.
2. Utilizar robots.txt con una finalidad concreta
Robots.txt restringe rastreo, no indexación ni privacidad. Si quieres que Google lea noindex, debe poder acceder a la página. No bloquees CSS, JavaScript o recursos necesarios para interpretar el contenido. La documentación oficial de robots.txt explica sus límites.
No apliques bloqueos masivos a parámetros sin comprobar si afectan a categorías o productos con demanda.
3. Mantener enlaces hacia destinos finales
Corrige enlaces internos a páginas eliminadas y evita cadenas o bucles de redirección. Una redirección permanente puede ser correcta en una migración; actualiza también los enlaces para no mantener saltos innecesarios.
Un 404 de contenido eliminado sin equivalente es una respuesta válida. No lo conviertas en redirección a inicio para mejorar un porcentaje del informe.
4. Alinear canonical, enlaces y sitemap
Incluye en el sitemap las URLs canónicas que quieras indexar, con fechas de modificación reales. Evita listar redirecciones y páginas excluidas. Google no utiliza priority o changefreq, y un sitemap no garantiza indexación. Consulta su guía para crear y enviar sitemaps.
Una canonical indica la versión preferida entre páginas equivalentes; no es una orden de dejar de rastrear todas las alternativas.
5. Revisar alojamiento y estabilidad
Investiga fallos 5xx, tiempos de respuesta y capacidad durante picos. Caché y consultas de base de datos pueden influir en la estabilidad, pero mide antes de cambiar de proveedor. Un hosting gestionado debe definir qué soporte y vigilancia incluye.
Qué datos consultar
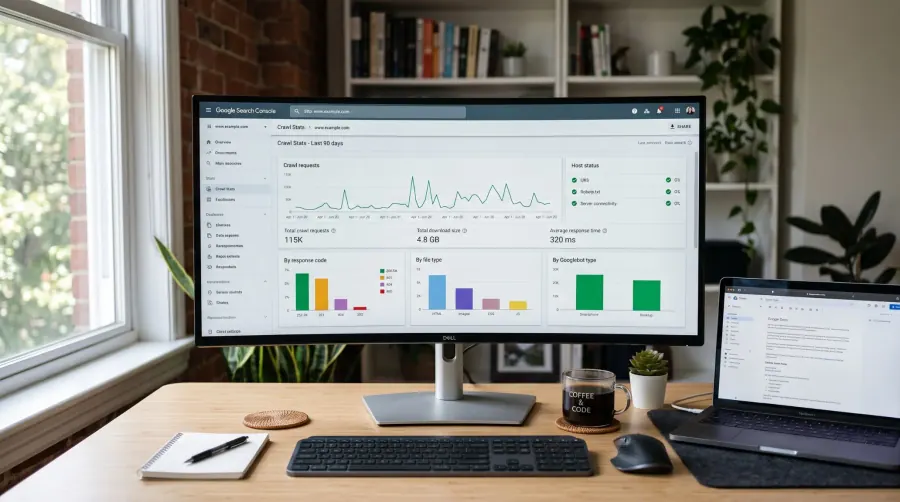
El informe de estadísticas de rastreo de Search Console permite observar solicitudes, respuestas y tiempos. Compara tendencias y episodios de error: no existe un umbral universal de 300 ms ni una proporción obligatoria de 200 que certifique una web sana.
Los registros de servidor ayudan a identificar URLs, frecuencia y errores, comprobando que las peticiones son del rastreador real. Un crawler como Screaming Frog permite revisar enlaces y estructura desde otra perspectiva; no reproduce todas las decisiones de Google.
Qué entregar tras una auditoría de rastreo
Pide una lista priorizada de problemas, ejemplos de URLs, evidencias y cambios propuestos. El objetivo debe ser que servicios y productos relevantes puedan descubrirse y leerse, sin perseguir más solicitudes como un fin en sí mismo.
¿Tu catálogo genera demasiadas URLs o Google no descubre páginas importantes?
Auditamos tu web y diseñamos una estrategia SEO orientada a captar clientes de forma orgánica, sin depender de la publicidad pagada.
Ver servicio de posicionamiento SEOEn LTEvo podemos revisar rastreo, indexación y arquitectura dentro de una auditoría SEO.